CLEAR выявила разрыв до 17 раз в числе токенов для разных языков
В выборке из 20 популярных языков разброс был меньше — от 1,5 до 5 раз; максимум зафиксировали в расширенном наборе примерно из 200 языков.
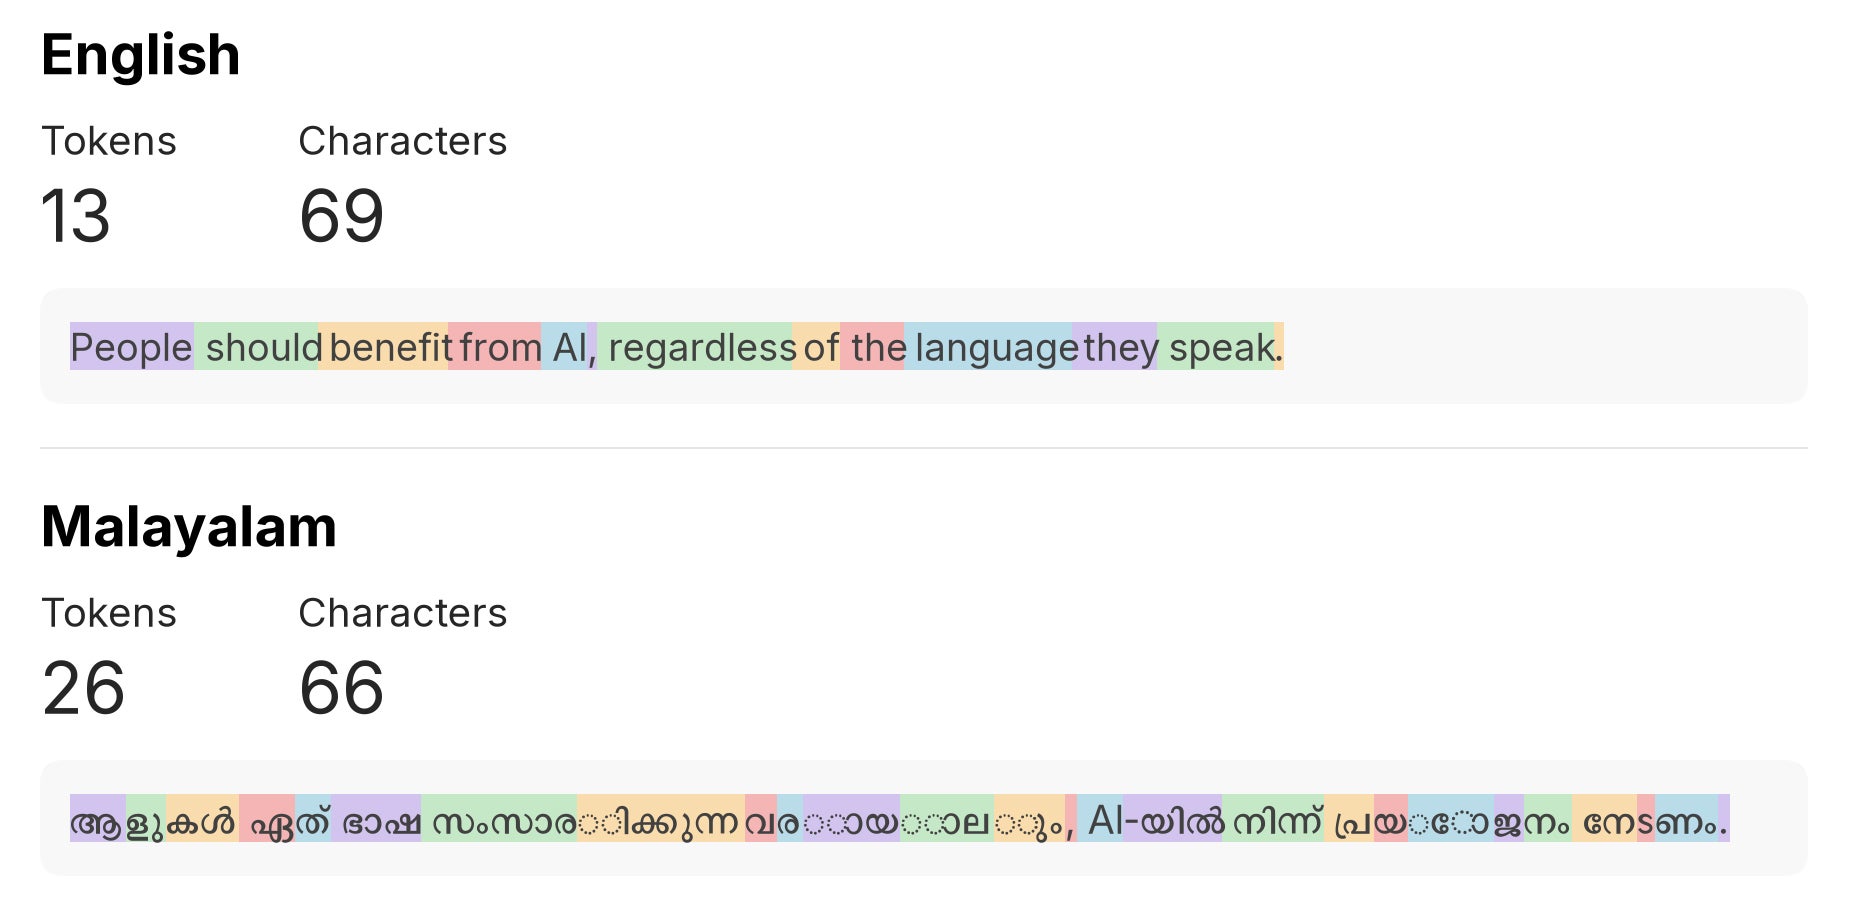
Коалиция CLEAR сравнила, сколько токенов требуется токенизаторам языковых моделей для обработки текстов на разных языках. В выборке из 20 наиболее популярных в интернете языков разница составила от 1,5 до 5 раз. В расширенном наборе примерно из 200 языков в одном из протестированных токенизаторов она достигла 17 раз.
Речь идёт о количестве токенов, а не о прямом сравнении счетов пользователей. Разница может влиять на стоимость в сервисах с оплатой за токены и на объём текста, помещающегося в контекст модели; само исследование не измеряло итоговые расходы на пользовательские запросы.
Результат зависит от языка, выборки и конкретного токенизатора. Исследование сравнивает токенизацию и само по себе не доказывает различия в качестве ответов моделей.
Что пока неизвестно
Измерялось число токенов, а не реальные счета или качество ответов. Итог зависит от выбранных языков, текстов и токенизатора.
Источники
Источник не открывается?
Оригинальная страница может быть временно недоступна. Попробуйте открыть её позже; название и дата источника сохранены выше.